
Logistic Regression
Nếu bạn vừa học xong Linear Regression, thì Logistic Regression là bước tiếp theo. Nó dùng gần như đúng những thành phần mà bạn đã thấy: đầu vào x, đầu ra y, một hàm loss, và Gradient Descent — nhưng giải một loại bài toán khác.
Trong Machine Learning có hai loại bài toán phổ biến: regression và classification. Linear Regression thuộc loại regression: nó dự đoán một giá trị liên tục như giá nhà hay điểm thi. Số lượng giá trị mà regression có thể cho ra là vô hạn, ví dụ giá nhà có thể là 1000, 2000, 1001, 1001.1, 1001.2… Mặt khác, Logistic Regression thuộc loại classification: nó giúp xác định mỗi mẫu dữ liệu thuộc nhóm nào trong các nhóm có sẵn.
Mẫu (sample): Một trường hợp cụ thể mà ta muốn mô hình xử lý. Trong bài toán lọc email, mỗi email là một mẫu; trong bài toán phát hiện gian lận, mỗi giao dịch là một mẫu. Mẫu được mô tả bằng các thông tin đầu vào, gọi là features.
Nhóm hay lớp (class): Một loại kết quả mà bài toán cho phép chọn. Ví dụ, bài toán lọc email có hai lớp: “spam” và “không spam”. Các lớp này được xác định trước theo mục tiêu bài toán.
Nhãn (label): Tên hoặc mã lớp gắn với một mẫu cụ thể. Chẳng hạn, email A có nhãn “spam”, có thể mã hóa là 1; email B có nhãn “không spam”, có thể mã hóa là 0.
Ví dụ, bạn có 100 email cần kiểm tra: đó là 100 mẫu, nhưng chỉ có 2 lớp để phân loại. Với mỗi email, mô hình dùng thông tin của email đó để dự đoán nhãn “spam” hoặc “không spam”.
Rất nhiều bài toán thực tế có dạng này: email là spam hay không spam, giao dịch là gian lận hay bình thường, khách hàng sẽ rời bỏ hay ở lại, kết quả xét nghiệm gợi ý có bệnh hay không bệnh, và sẽ không có một giá trị ở giữa, số lượng dự đoán của mô hình là hữu hạn. Ở tất cả những bài toán đó, đầu ra không phải một con số tùy ý mà là một trong hai (hoặc một vài) nhãn.
Có một điều dễ gây bối rối ngay từ cái tên:
Dù tên có chữ “Regression”, Logistic Regression chủ yếu được sử dụng cho bài toán classification (phân loại).
Classification (phân loại): Dự đoán mẫu thuộc nhóm nào. Binary classification có hai nhóm, thường mã hóa bằng nhãn 0 và 1.
Định nghĩa: Logistic Regression
Logistic Regression là một mô hình phân loại (classification). Cách nó hoạt động gồm đúng hai bước.
Bước 1 — Tính một điểm số tuyến tính (linear score). Giống hệt Linear Regression, mô hình kết hợp các đặc trưng đầu vào bằng trọng số:
Ở đây, ta dùng z thay vì y vì đây chỉ là một giá trị trung gian cho bước tiếp theo, không phải là dự đoán cuối cùng. Trong machine learning, chỉ dự đoán cuối cùng mới được gọi là y.
Bước 2 — Nén điểm số thành xác suất. Vấn đề là z có thể là một số bất kỳ, từ âm vô cùng đến dương vô cùng — không thể coi là xác suất. Do đó, ta cần đưa z qua hàm sigmoid để ép nó về khoảng từ 0 đến 1:
Giải thích từng ký hiệu:
x: đặc trưng (feature) hoặc vector đặc trưng.w: trọng số (weight) — mỗi feature một trọng số.b: bias — hằng số dịch chuyển.z: linear score, còn gọi là logit.p̂(đọc là “p mũ”): xác suất mô hình dự đoán cho lớp có giá trị 1.σ: hàm sigmoid. Output của hàm sigmoid luôn luôn nằm trong khoảng từ 0 đến 1.
Feature / vector đặc trưng: Feature là một thông tin đầu vào; vector là danh sách các features của cùng một mẫu.
Weight / bias: Weight nhân với từng feature; bias là phần cộng thêm vào tổng.
Logit (linear score): Điểm số trước sigmoid, có thể âm hoặc dương và chưa phải xác suất.
Sigmoid: Hàm đổi một điểm số thành giá trị từ 0 đến 1, dùng làm xác suất dự đoán.
Thông điệp cốt lõi của cả bài, cần nhớ ngay từ đây:
Logistic Regression không trực tiếp dự đoán nhãn 0 hoặc 1. Nó dự đoán một xác suất, sau đó dùng một threshold (ngưỡng) để chuyển xác suất đó thành nhãn.
Threshold (ngưỡng quyết định): Mốc đổi xác suất thành nhãn. Với ngưỡng 0.5, xác suất từ 0.5 trở lên được xếp vào lớp 1.
Đọc đồ thị: Trục ngang là điểm số , không phải feature đầu vào . Trục dọc là xác suất . Khi âm, xác suất nhỏ hơn ; khi , xác suất bằng ; khi dương, xác suất lớn hơn .
Tính từng bước từ input đến dự đoán
Hãy lấy bài toán dự đoán học sinh đậu hay chưa đậu dựa trên số giờ ôn tập . Quy ước lớp 1 là “đậu”, lớp 0 là “chưa đậu”. Giả sử mô hình có và :
Đây là bộ tham số minh họa để dễ tính, không phải kết luận thực tế về số giờ cần học để đậu. Ta dùng threshold : xác suất từ trở lên thì dự đoán lớp 1; thấp hơn thì dự đoán lớp 0.
Hàm exp: là cách viết khác của , với . Hãy tính dấu của trước: nếu thì , còn nếu thì .
Ví dụ 1 — Ôn tập 2 giờ: input dẫn đến điểm số âm.
- Tính điểm số từ input:
- Tính phần mũ trong mẫu số:
- Tính toàn bộ sigmoid:
- Ra quyết định: Xác suất đậu dự đoán khoảng 11.92%. Vì , nhãn dự đoán là 0 — chưa đậu.
Ví dụ 2 — Ôn tập 4 giờ: input nằm đúng ngưỡng quyết định.
- Tính điểm số từ input:
- Tính phần mũ trong mẫu số:
- Tính toàn bộ sigmoid:
- Ra quyết định: Xác suất đậu dự đoán là 50%. Theo quy ước lấy lớp 1 khi , nhãn dự đoán là 1 — đậu. Đây là điểm đúng ngưỡng, không phải dự đoán chắc chắn sẽ đậu.
Ví dụ 3 — Ôn tập 6 giờ: input dẫn đến điểm số dương.
- Tính điểm số từ input:
- Tính phần mũ trong mẫu số:
- Tính toàn bộ sigmoid:
- Ra quyết định: Xác suất đậu dự đoán khoảng 88.08%. Vì , nhãn dự đoán là 1 — đậu.
Nhớ cả chuỗi tính toán: Input được đổi thành điểm số bằng weights và bias. Sigmoid đổi thành xác suất; threshold đổi xác suất thành nhãn cuối cùng. Các số thập phân trong ví dụ được làm tròn để dễ đọc.
Huấn luyện mô hình Logistic Regression
“Huấn luyện” ở đây cũng giống Linear Regression: đi tìm w và b. Nhưng mục tiêu được phát biểu lại cho phù hợp với xác suất:
Tìm
wvàbsao cho xác suất dự đoán khớp với nhãn thật nhất có thể.
Cụ thể:
- Với một mẫu có nhãn thật
y = 1, ta muốn mô hình chop̂gần 1. - Với một mẫu có nhãn thật
y = 0, ta muốn mô hình chop̂gần 0.
Hàm mất mát (Loss function)
Ta cần một hàm loss đo được “mức lệch” này. Ở đây ta không dùng MSE làm loss chính (lý do ở phần sau). Loss chuẩn cho Logistic Regression là Binary Cross-Entropy, còn gọi là Log Loss:
Binary Cross-Entropy (BCE): Loss so sánh xác suất với nhãn 0/1, phạt nặng khi mô hình tự tin vào nhãn sai.
Công thức trông hơi cồng kềnh, nhưng thực ra nó rất khéo: với mỗi mẫu, chỉ một trong hai số hạng “sống sót”, tùy theo nhãn thật là 0 hay 1.
Ở đây, là logarit tự nhiên (cơ số ), cũng viết là . Ta sẽ tính loss cho một mẫu trước; loss của cả tập dữ liệu là trung bình loss của các mẫu. Dùng trực tiếp xác suất để tính, chưa chuyển thành nhãn bằng threshold.
Khi y = 1
Số hạng (1 - y) bằng 0, nên loss của mẫu đó rút gọn thành:
Giả sử email thật sự là spam, tức nhãn gốc .
Dự đoán gần nhãn gốc: Mô hình cho , tức xác suất spam là 90%. Thay vào công thức:
Dự đoán xa nhãn gốc: Mô hình chỉ cho , tức xác suất spam là 10%:
Vậy cùng một email có nhãn 1, dự đoán cho loss khoảng 0.1054, còn dự đoán cho loss khoảng 2.3026 — lớn hơn khoảng 22 lần. Nếu dự đoán càng sai và càng tự tin, chẳng hạn , loss tăng thành .
Khi y = 0
Số hạng y bằng 0, loss rút gọn thành:
Giờ xét email thật sự không spam, tức nhãn gốc . Lưu ý: vẫn là xác suất spam; xác suất dành cho nhãn đúng lúc này là .
Dự đoán gần nhãn gốc: Mô hình cho . Tính phần trong log trước, rồi tính loss:
Dự đoán xa nhãn gốc: Mô hình cho :
Với nhãn 0, dự đoán cho loss khoảng 0.1054, còn dự đoán cho loss khoảng 2.3026. Nếu , xác suất dành cho nhãn đúng chỉ còn , nên loss là .
Đọc hai đồ thị: Trục ngang là xác suất của lớp 1; trục dọc là loss của một mẫu. Hai điểm được đánh dấu là các phép tính vừa làm. Khi , cả hai trường hợp đều có loss . Khi xác suất tiến sát nhãn thật, loss tiến về 0; khi tiến sát nhãn đối lập, loss tăng không giới hạn. không xác định, nên ở đây mô tả giới hạn, không phải kết quả thay trực tiếp 0 vào log.
Gộp lại thành một câu trực giác cần nhớ:
Cross-Entropy phạt rất nặng những dự đoán vừa sai vừa quá tự tin.
Đây là điểm tinh tế nhất của hàm loss này. Nếu mô hình dự đoán p̂ = 0.99 (rất chắc chắn là lớp 1) mà nhãn thật lại là 0, loss vọt lên cực lớn. Ngược lại, nếu mô hình dự đoán p̂ = 0.55 mà sai, loss chỉ tăng vừa phải. Nói cách khác, hàm loss này khuyến khích mô hình hiệu chỉnh sự tự tin cho tương xứng với thực tế, chứ không chỉ đoán đúng nhãn.
Gradient Descent
Gradient Descent: Điều chỉnh từng chút các trọng số
wvà biasbđể tìm cách giảm loss.Gradient: Thông tin giúp xác định nên tăng hay giảm từng tham số để loss giảm.
Learning rate: Quyết định mỗi lần điều chỉnh tham số một bước lớn hay nhỏ.
Nếu bạn đã hiểu Gradient Descent ở bài Linear Regression thì phần này gần như không có gì mới. Quy trình lặp lại y hệt, chỉ khác ở hàm dự đoán và hàm loss:
- Tính điểm số
z = wx + bvới một feature. Nếu có nhiều features, nhân từng feature với trọng số tương ứng, cộng các kết quả rồi cộng thêmb. - Đưa
zqua sigmoid để được xác suấtp̂. - Tính Binary Cross-Entropy giữa
p̂và nhãn thật. - Dùng gradient để xác định hướng điều chỉnh từng trọng số
wvà biasb. - Điều chỉnh các tham số một bước theo learning rate.
- Tính lại dự đoán và loss với các tham số mới, rồi tiếp tục lặp. Có thể dừng khi loss gần như không giảm nữa hoặc đã đủ số lượt huấn luyện.
Công thức cập nhật Gradient Descent giống hệt dạng ở Linear Regression:
Ở đây, là learning rate; và là gradient của loss theo từng tham số, được tính từ cùng bộ tham số cũ trước khi cập nhật.
Lưu ý: Quy tắc cập nhật vẫn là tham số mới = tham số cũ − learning rate × gradient. Phần tính gradient sẽ khác vì hàm loss khác nhau: Linear Regression dùng MSE, còn Logistic Regression dùng Binary Cross-Entropy.
Linear Regression và Logistic Regression khác nhau ở hàm dự đoán và hàm loss, nhưng quá trình train thì giống nhau: tìm bộ tham số làm loss nhỏ nhất bằng Gradient Descent. Đây chính là khuôn mẫu bạn sẽ gặp lại ở mọi mô hình phức tạp hơn, kể cả neural network.
Đánh giá Logistic Regression
Giả sử bạn đã huấn luyện xong một mô hình lọc email spam. Mô hình đã đưa ra dự đoán, nhưng làm sao biết những dự đoán đó có đủ tốt để sử dụng?
Trong lúc huấn luyện, ta dùng Binary Cross-Entropy để đo sai số và điều chỉnh tham số. Bây giờ, ta cần nhìn kết quả theo cách gần với việc sử dụng bộ lọc hơn: nó có nhận ra spam không, có bỏ sót nhiều không, và có đưa nhầm email công việc vào thư mục spam không? Mỗi thước đo dưới đây giúp trả lời một phần của những câu hỏi ấy.
Để dễ theo dõi, ta sẽ dùng bài toán lọc email xuyên suốt phần này. Ta quy ước spam mang nhãn 1, còn email thường mang nhãn 0. Những email dùng để đánh giá đã được gán nhãn thật và không được dùng để cập nhật tham số khi huấn luyện. Nhờ vậy, ta có thể so sánh dự đoán với đáp án đã biết để xem mô hình xử lý dữ liệu mới ra sao.
Accuracy: Đoán đúng bao nhiêu phần trăm?
Cách kiểm tra đầu tiên khá tự nhiên: đếm xem mô hình phân loại đúng bao nhiêu email trong tổng số email đã kiểm tra. Một dự đoán được tính là đúng khi mô hình nhận ra spam là spam, hoặc nhận ra email thường là email thường.
Accuracy (độ chính xác tổng thể) là tỉ lệ dự đoán đúng trên toàn bộ dữ liệu đang đánh giá. Chỉ số này tính cả hai loại email, không chỉ riêng spam.
Ví dụ, kiểm tra 10 email, mô hình phân loại đúng 8 email, sai 2 email:
Accuracy bằng 80% cho biết mô hình đã xử lý đúng 8 trong 10 email. Tuy nhiên, ta vẫn chưa biết hai email bị đoán sai là spam bị bỏ lọt hay email thường bị chặn nhầm. Sự khác biệt này rất quan trọng: bỏ lọt một email quảng cáo và chặn nhầm một email công việc gây ra những phiền toái khác nhau.
Vì sao accuracy cao có thể không giúp ích trên dữ liệu lệch lớp?
Để thấy giới hạn của accuracy rõ hơn, hãy tạm xét một hộp thư lớn hơn: có 1,000 email, trong đó 990 email thường và chỉ 10 email spam. Hai loại email xuất hiện với số lượng rất khác nhau.
Dữ liệu lệch lớp (imbalanced dataset) là dữ liệu có một lớp xuất hiện nhiều hơn hẳn lớp khác. Trong ví dụ này, email thường chiếm gần hết hộp thư, còn spam chỉ chiếm một phần nhỏ.
Nếu mô hình luôn trả lời “email thường” cho mọi email, nó vẫn đoán đúng 990 email. Chỉ có 10 email spam bị đoán sai. Khi đó:
Mô hình đạt 99% accuracy mà không phát hiện được một email spam nào. Nếu mục tiêu là lọc spam, con số này không chứng minh mô hình hữu ích: chỉ cần luôn chọn lớp đông nhất là đã đạt được 99%, không cần học từ nội dung email.
Accuracy vẫn tính đúng tỉ lệ đoán đúng, nhưng dùng riêng nó để kết luận mô hình tốt trên dữ liệu lệch lớp có thể gây hiểu nhầm. Ta cần xem mô hình bỏ sót bao nhiêu spam và chặn nhầm bao nhiêu email thường.
TP, FP, FN, TN: Bốn kết quả có thể xảy ra
Để hiểu mô hình đang sai như thế nào, ta cần phân biệt hai việc: email thực sự thuộc loại nào, và mô hình đã dự đoán nó thuộc loại nào. Ghép hai thông tin này lại, ta có bốn trường hợp. Hãy nhìn từng email trong bảng dưới đây trước khi học tên viết tắt:
| Nhãn thật | Mô hình dự đoán | Kết quả | |
|---|---|---|---|
| A | Spam | Spam | Bắt đúng spam |
| B | Email thường | Spam | Chặn nhầm email thường |
| C | Spam | Email thường | Bỏ sót spam |
| D | Email thường | Email thường | Giữ đúng email thường |
Bốn trường hợp trên thường được viết tắt là TP, FP, FN và TN. Bạn không cần học thuộc ngay cả bốn tên; hãy đọc chúng theo hai phần:
- Positive / Negative nói về dự đoán của mô hình: Positive là dự đoán spam (1), Negative là dự đoán email thường (0).
- True / False cho biết dự đoán đó đúng hay sai khi đối chiếu nhãn thật.
“Positive” không có nghĩa là tốt: đó chỉ là tên lớp ta chọn làm lớp 1, ở đây là spam.
| Ký hiệu | Tên đầy đủ | Cách nhớ trong bài toán email |
|---|---|---|
| TP | True Positive | Email A thật sự là spam và được mô hình nhận ra đúng. |
| FP | False Positive | Email B là email thường nhưng bị mô hình gọi nhầm là spam. |
| FN | False Negative | Email C là spam nhưng bị mô hình bỏ lọt vì dự đoán là email thường. |
| TN | True Negative | Email D là email thường và được mô hình nhận ra đúng. |
Hai lỗi cần phân biệt: FP có thể làm mất email công việc quan trọng vì bị chặn nhầm. FN khiến spam vẫn xuất hiện trong hộp thư vì bị bỏ lọt.
Confusion matrix: Gom bốn kết quả vào một bảng
Quay lại ví dụ 10 email, đúng 8 và sai 2. Giả sử có 4 email spam và 6 email thường. Mô hình bắt đúng 3 spam, bỏ sót 1 spam, chặn nhầm 1 email thường và giữ đúng 5 email thường.
Thay vì đọc kết quả của từng email, ta có thể gom chúng vào một bảng. Bảng này giúp ta nhìn ngay được mô hình làm đúng ở đâu và nhầm lẫn ở đâu.
Confusion matrix (ma trận nhầm lẫn) là bảng đếm số dự đoán thuộc từng trường hợp TP, FP, FN và TN. Mỗi ô trả lời câu hỏi: có bao nhiêu email mang nhãn thật này được mô hình dự đoán thành nhãn kia?
Trong bảng dưới đây, hàng là nhãn thật, còn cột là nhãn dự đoán. Ví dụ, ô giao giữa hàng “Email thường” và cột “Spam” chứa những email thường bị chặn nhầm:
| Nhãn thật ↓ / Dự đoán → | Email thường (0) | Spam (1) | Tổng thực tế |
|---|---|---|---|
| Email thường (0) | 5 — TN: giữ đúng | 1 — FP: chặn nhầm | 6 |
| Spam (1) | 1 — FN: bỏ sót | 3 — TP: bắt đúng | 4 |
| Tổng dự đoán | 6 | 4 | 10 |
Biểu diễn cùng số liệu bằng heatmap, như khi vẽ confusion matrix với Seaborn:
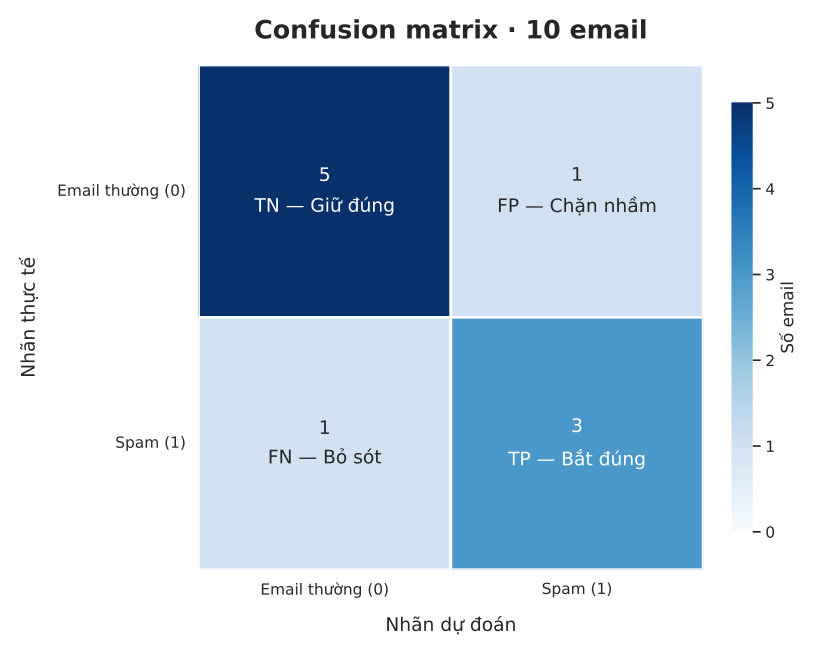
Cách đọc màu: Thanh màu bên phải biểu thị số email từ 0 đến 5. Ô càng xanh đậm thì càng nhiều email rơi vào ô đó; màu đậm không tự có nghĩa là tốt hay xấu. Ví dụ, ô TN = 5 đậm nhất vì có 5 email thường được giữ đúng; ô FP = 1 nhạt vì có 1 email thường bị chặn nhầm.
Cách đọc từng bước:
- Đọc hàng email thường: có 6 email thật sự bình thường; 5 được giữ đúng, 1 bị gọi nhầm là spam.
- Đọc hàng spam: có 4 email thật sự là spam; 1 bị bỏ sót, 3 được bắt đúng.
- Đọc cột spam: mô hình gọi 4 email là spam; trong đó 3 đúng, 1 nhầm.
- Hai ô trên đường chéo chính (5 và 3) là dự đoán đúng. Hai ô còn lại là dự đoán sai. Accuracy vẫn là (5 + 3) / 10 = 80%.
Hãy đọc tên trục trước: một số hình có thể đặt hàng là dự đoán, cột là thực tế. Với
confusion_matrixcủa scikit-learn và thứ tự nhãn[0, 1], bảng có dạng[[TN, FP], [FN, TP]], như trên.
Precision: Những email bị gọi là spam có đáng tin không?
Giả sử bạn mở thư mục spam và thấy có 4 email trong đó. Điều bạn muốn biết lúc này là: cả 4 email có thật sự là spam không, hay bộ lọc đã đưa nhầm email quan trọng vào đây? Đó là câu hỏi mà precision giúp trả lời.
Precision là tỉ lệ dự đoán đúng trong số các trường hợp mô hình gọi là lớp 1. Với bộ lọc email, ta chỉ xét những email bị gọi là spam rồi kiểm tra có bao nhiêu email thật sự là spam.
Ở cột spam của bảng, mô hình gọi 4 email là spam, nhưng chỉ 3 email thật sự là spam:
Ở đây, tử số là 3 email spam được nhận ra đúng. Mẫu số gồm toàn bộ 4 email bị gọi là spam: 3 email gọi đúng và 1 email gọi nhầm.
Precision 75% nghĩa là: trong 4 email bị chặn ở ví dụ này, có 3 email chặn đúng và 1 email chặn nhầm. Precision cao hữu ích khi muốn tránh chặn nhầm email thường, chẳng hạn email công việc.
Precision chỉ nhìn nhóm đã bị gọi là spam. Nó chưa cho biết ngoài nhóm đó còn bao nhiêu spam bị bỏ lọt.
Recall: Có tìm được hết spam không?
Sau khi kiểm tra thư mục spam, bạn tiếp tục nhìn vào hộp thư đến và phát hiện vẫn còn spam lọt qua. Lúc này, câu hỏi đã đổi: trong tất cả spam gửi đến, bộ lọc đã tìm ra được bao nhiêu? Để trả lời, ta dùng recall.
Recall là tỉ lệ trường hợp thuộc lớp 1 được mô hình tìm ra. Với bộ lọc email, ta xét tất cả email thật sự là spam, bao gồm cả những email đã bị chặn và những email còn bị bỏ lọt.
Ở hàng spam của bảng, thực tế có 4 email spam, mô hình bắt được 3 email:
Tử số vẫn là 3 email spam được nhận ra đúng. Nhưng mẫu số lần này gồm tất cả spam thật: 3 email đã tìm ra và 1 email bị bỏ sót. Đây là điểm khác biệt quan trọng so với precision.
Recall 75% nghĩa là: trong 4 email spam thật, mô hình tìm ra 3 và bỏ sót 1. Recall cao hữu ích khi muốn bắt được nhiều spam, hạn chế bỏ lọt.
Precision và recall khác nhau ở đâu?
Hai con số trên tình cờ đều bằng 75%, nhưng chúng xét hai nhóm khác nhau:
| Thước đo | Nhóm được xét ở mẫu số | Câu hỏi |
|---|---|---|
| Precision | Các email mô hình gọi là spam | Gọi spam có đúng không? |
| Recall | Các email thật sự là spam | Đã tìm được bao nhiêu spam? |
Giữ nguyên 10 email có 4 spam và 6 email thường, nhưng xét hai cách chặn khác:
| Cách chặn | Kết quả | Precision | Recall |
|---|---|---|---|
| Chỉ chặn 1 email chắc nhất, và đó đúng là spam | Bắt đúng 1, chặn nhầm 0, bỏ sót 3 | 1 / 1 = 100% | 1 / 4 = 25% |
| Chặn cả 10 email | Bắt đúng 4, chặn nhầm 6, bỏ sót 0 | 4 / 10 = 40% | 4 / 4 = 100% |
Cách thứ nhất gọi spam rất chính xác nhưng bỏ sót nhiều. Cách thứ hai không bỏ sót spam nhưng chặn nhầm toàn bộ email thường. Vì vậy, precision cao chưa đủ, recall cao cũng chưa đủ.
Ta điều chỉnh cách chặn bằng threshold. Tăng ngưỡng khiến ít email được gọi là spam hơn, có thể giảm chặn nhầm nhưng cũng bỏ sót thêm. Hạ ngưỡng khiến nhiều email được gọi là spam hơn, có thể bắt thêm spam nhưng cũng chặn nhầm thêm. Precision không nhất thiết tăng hoặc giảm đều ở mọi lần đổi ngưỡng; cần tính lại trên dữ liệu thực tế.
F1-score: Kết hợp precision và recall
Hai cách chặn ở trên cho thấy ta khó đánh giá bộ lọc bằng riêng precision hoặc recall. Một mô hình có thể chỉ chặn rất ít email để ít bị nhầm, nhưng lại bỏ lọt gần hết spam. Nếu muốn có một con số phản ánh đồng thời hai mặt này, ta có thể dùng F1-score.
F1-score là chỉ số kết hợp precision và recall. F1 chỉ cao khi cả hai cùng cao; một chỉ số rất cao không đủ bù cho chỉ số còn lại quá thấp.
Công thức kết hợp hai chỉ số là:
Với ví dụ confusion matrix, cả hai đều bằng 0.75:
Với cách chỉ chặn 1 email, precision là 1 nhưng recall chỉ 0.25:
Precision 100% không làm F1 cao nếu recall quá thấp. F1 hữu ích khi muốn xét đồng thời hai thước đo, nhưng nếu cần ưu tiên tránh chặn nhầm hay tránh bỏ sót, ta vẫn phải xem riêng từng loại lỗi.
ROC-AUC: Mô hình có xếp spam lên trên email thường không?
Đến đây, ta đã đánh giá các nhãn mà mô hình đưa ra: spam hoặc email thường. Nhưng hãy nhớ rằng Logistic Regression ban đầu trả về một xác suất. Ta phải chọn ngưỡng, chẳng hạn 0.5, rồi mới đổi xác suất đó thành nhãn để tính accuracy, precision, recall và F1.
Nếu thay ngưỡng, những email bị chặn có thể thay đổi và các chỉ số trên cũng thay đổi theo. Vì vậy, ta còn muốn biết: trước khi chốt ngưỡng, mô hình có thường cho spam xác suất cao hơn email thường không? ROC-AUC giúp đánh giá khả năng phân biệt này.
ROC-AUC là chỉ số tóm tắt khả năng phân biệt hai lớp qua nhiều ngưỡng dự đoán. Trong bài toán này, hãy hình dung nó kiểm tra xem mô hình có xếp spam lên trước email thường khi sắp xếp theo xác suất spam hay không.
Bước 1: Xem xác suất trước khi chọn ngưỡng
Để tính tay dễ hơn, dùng ví dụ riêng gồm 4 email: 2 spam và 2 email thường. Xếp theo xác suất spam dự đoán từ cao xuống thấp:
| Nhãn thật | Xác suất spam dự đoán | |
|---|---|---|
| A | Spam (1) | 0.9 |
| B | Email thường (0) | 0.8 |
| C | Spam (1) | 0.6 |
| D | Email thường (0) | 0.1 |
Thứ tự lý tưởng đặt cả A và C lên trên B và D. Ở đây mô hình đã xếp nhầm B cao hơn C. Điều này ảnh hưởng thế nào khi đổi threshold?
Bước 2: Đổi threshold và đếm hai tỉ lệ
Với mỗi ngưỡng, ta đếm hai việc: mô hình đã tìm ra bao nhiêu phần trong số spam thật, và đã chặn nhầm bao nhiêu phần trong số email thường. Ta sẽ dùng hai tỉ lệ này làm tọa độ trên đồ thị ROC.
TPR (True Positive Rate) là tỉ lệ spam được tìm ra, cũng chính là recall. FPR (False Positive Rate) là tỉ lệ email thường bị gọi nhầm là spam. Trên đồ thị ROC, FPR nằm ở trục ngang, còn TPR nằm ở trục dọc.
Trong ví dụ có 2 spam và 2 email thường, nếu bắt đúng 1 spam thì TPR bằng 50%. Nếu đồng thời chặn nhầm 1 email thường thì FPR cũng bằng 50%. Ta muốn tìm được nhiều spam, vì vậy TPR càng cao càng tốt; ta muốn ít chặn nhầm email thường, vì vậy FPR càng thấp càng tốt.
FPR khác precision: FPR nhìn vào tất cả email thường rồi đếm phần bị chặn nhầm. Precision nhìn vào tất cả email bị gọi là spam rồi đếm phần gọi đúng. Vì mẫu số khác nhau, FPR không phải là 1 − precision.
Quy ước xác suất lớn hơn hoặc bằng threshold thì gọi là spam:
| Threshold | Email được gọi là spam | Spam bắt đúng | Email thường chặn nhầm | FPR (ngang) | TPR (dọc) |
|---|---|---|---|---|---|
| 1.0 | Không có | 0 / 2 | 0 / 2 | 0% | 0% |
| 0.9 | A | 1 / 2 | 0 / 2 | 0% | 50% |
| 0.8 | A, B | 1 / 2 | 1 / 2 | 50% | 50% |
| 0.6 | A, B, C | 2 / 2 | 1 / 2 | 50% | 100% |
| 0.1 | A, B, C, D | 2 / 2 | 2 / 2 | 100% | 100% |
Hạ ngưỡng từ 0.9 xuống 0.8 chỉ thêm B: chặn nhầm thêm một email thường mà chưa bắt thêm spam. Hạ tiếp xuống 0.6 mới bắt thêm C, tìm đủ cả hai spam.
Bước 3: Vẽ đường ROC và đọc diện tích AUC
Mỗi hàng trong bảng cho một điểm (FPR, TPR). Nối lần lượt các điểm, ta được đường ROC:
Càng gần góc trên bên trái, càng tốt: bắt được nhiều spam (TPR cao), chặn nhầm ít email thường (FPR thấp). Đường chéo nét đứt là mốc tham chiếu của cách xếp hạng ngẫu nhiên; đường ROC trên một tập mẫu nhỏ có thể dao động quanh mốc đó.
AUC viết tắt của Area Under the Curve: diện tích dưới đường ROC. Vì cả hai trục chạy từ 0 đến 1, diện tích nằm trong khoảng 0 đến 1.
Chia vùng tô thành hai hình chữ nhật: nửa bên trái rộng 0.5, cao 0.5; nửa bên phải rộng 0.5, cao 1:
Hiểu AUC bằng cách so sánh từng cặp email
Lấy từng spam ghép với từng email thường rồi kiểm tra: mô hình có cho spam điểm cao hơn không? Có 2 spam × 2 email thường = 4 cặp:
| Cặp so sánh | Xác suất của spam và email thường | Spam được xếp cao hơn? |
|---|---|---|
| A và B | 0.9 và 0.8 | Có |
| A và D | 0.9 và 0.1 | Có |
| C và B | 0.6 và 0.8 | Không |
| C và D | 0.6 và 0.1 | Có |
Có 3 / 4 cặp xếp đúng, nên AUC = 0.75, khớp cách tính diện tích. Nếu hai email trong một cặp có cùng điểm, cặp đó được tính nửa điểm.
- AUC = 1: Mọi spam được xếp cao hơn mọi email thường trong tập đánh giá.
- AUC khoảng 0.5: Khả năng xếp hạng gần mức ngẫu nhiên.
- AUC dưới 0.5: Thứ tự có xu hướng bị đảo; nên kiểm tra quy ước nhãn và xác suất đang lấy cho lớp nào.
AUC = 0.75 không có nghĩa accuracy = 75%. Với bốn email trên, threshold 0.5 gọi A, B, C là spam: đúng 3/4 email, accuracy 75%. Nhưng threshold 0.8 chỉ gọi A, B là spam: đúng 2/4 email, accuracy còn 50%. AUC vẫn là 0.75 vì các điểm số và thứ tự xếp hạng không đổi.
ROC-AUC có đủ để chọn mô hình không?
ROC-AUC đánh giá khả năng xếp hạng mà không chốt một threshold duy nhất. Nó không tự chọn ngưỡng chặn email và không cho biết mọi xác suất dự đoán đã sát thực tế hay chưa.
Với dữ liệu rất lệch lớp, còn phải nhìn số email chặn nhầm thực tế. Ví dụ có 10 spam và 990 email thường, mô hình bắt được 8 spam và chặn nhầm 10 email thường:
- TPR = 8 / 10 = 80%.
- FPR = 10 / 990 ≈ 1.01%, trông khá nhỏ.
- Precision = 8 / (8 + 10) ≈ 44.4%: hơn nửa email bị chặn lại là email thường.
Đây là một điểm trên ROC, chưa đủ để tính AUC. Ví dụ cho thấy ngay cả khi FPR nhỏ, ta vẫn cần xem confusion matrix, precision và recall ở threshold định sử dụng.
Khi đánh giá một bộ lọc email, bạn có thể bắt đầu bằng confusion matrix để nhìn rõ số email bị chặn nhầm và số spam bị bỏ lọt. Sau đó, đọc precision để biết những email bị chặn có thực sự là spam không, rồi đọc recall để biết bộ lọc đã tìm ra được bao nhiêu spam. Accuracy cho biết tỉ lệ đúng tổng thể, còn F1 giúp tóm tắt precision và recall bằng một con số.
Nếu muốn so sánh khả năng xếp hạng của các mô hình trước khi chọn ngưỡng, bạn có thể xem thêm ROC-AUC. Cuối cùng, ngưỡng sử dụng vẫn phải phù hợp với nhu cầu thực tế: bạn chấp nhận bỏ lọt thêm một ít spam để giảm nguy cơ chặn nhầm email công việc, hay muốn lọc spam mạnh hơn? Hãy chọn ngưỡng trên tập validation, rồi đánh giá lần cuối trên tập test được giữ riêng.
Code Logistic Regression với scikit-learn
Trong thực tế, bạn hiếm khi tự cài đặt thuật toán — scikit-learn đã làm sẵn. Ví dụ dưới đây dùng make_classification để tạo dữ liệu giả lập nên chạy được ngay, không cần tải gì:
import numpy as npfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import make_pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import (    confusion_matrix, accuracy_score, precision_score,    recall_score, f1_score, roc_auc_score,)
# 1. Tạo dữ liệu classification giả lập (mất cân bằng nhẹ 70/30)X, y = make_classification(    n_samples=1000, n_features=10, n_informative=5,    n_redundant=2, weights=[0.7, 0.3], random_state=42,)
# 2. Chia train/test (giữ tỉ lệ lớp bằng stratify)X_train, X_test, y_train, y_test = train_test_split(    X, y, test_size=0.2, stratify=y, random_state=42,)
# 3. Pipeline: StandardScaler + LogisticRegression#    Scaler chỉ fit trên train set -> tránh data leakagemodel = make_pipeline(    StandardScaler(),    LogisticRegression(max_iter=1000, random_state=42),)model.fit(X_train, y_train)
# 4. Dự đoán nhãn và xác suấty_pred = model.predict(X_test)              # nhãn 0/1 (threshold 0.5)y_proba = model.predict_proba(X_test)[:, 1] # xác suất của lớp 1
# 5. Đánh giáprint("Confusion matrix:")print(confusion_matrix(y_test, y_pred))print(f"Accuracy:  {accuracy_score(y_test, y_pred):.3f}")print(f"Precision: {precision_score(y_test, y_pred):.3f}")print(f"Recall:    {recall_score(y_test, y_pred):.3f}")print(f"F1:        {f1_score(y_test, y_pred):.3f}")print(f"ROC-AUC:   {roc_auc_score(y_test, y_proba):.3f}")
# 6. Xem vài xác suất dự đoán đầu tiênprint("\nMột vài xác suất dự đoán cho lớp 1:")for prob in y_proba[:5]:    print(f"  P(lớp 1) = {prob:.3f}")
Pipeline: Ghép các bước xử lý dữ liệu và mô hình thành một quy trình thống nhất.
StandardScaler: Trừ trung bình và chia độ lệch chuẩn của từng feature; chỉ học các thống kê này từ tập train.
Train/test split / data leakage: Train là dữ liệu để học, test là dữ liệu giữ riêng để đánh giá. Leakage xảy ra khi thông tin của test lọt vào quá trình học.
Vài điểm cần nắm sau đoạn code:
.predict()trả về nhãn (0 hoặc 1), dùng threshold mặc định 0.5..predict_proba()trả về xác suất cho từng lớp; ta lấy cột[:, 1]là xác suất lớp dương.- Vì dùng
Pipeline,StandardScalerchỉ đượcfittrên train set (trong.fit()) rồi áp dụng lại cho test set — đây là cách chuẩn để tránh data leakage. - Nếu muốn đổi threshold, hãy làm việc trên
y_probathay vì dùng thẳng.predict(), ví dụ:y_custom = (y_proba >= 0.3).astype(int).
Code Logistic Regression từ đầu bằng NumPy
Phần này không bắt buộc, nhưng cực kỳ đáng giá: tự viết Gradient Descent để thấy mô hình thực sự “học” như thế nào. Đây là bản giáo dục, ưu tiên dễ đọc hơn là tối ưu.
import numpy as np
# Dữ liệu giả lập: 2 feature, nhãn 0/1np.random.seed(42)n = 200X = np.random.randn(n, 2)true_w = np.array([2.0, -3.0])logits = X @ true_w + 0.5y = (1 / (1 + np.exp(-logits)) > 0.5).astype(float)
def sigmoid(z):    z = np.clip(z, -500, 500)     # clip để tránh tràn số (overflow)    return 1 / (1 + np.exp(-z))
# Khởi tạo tham sốw = np.zeros(X.shape[1])b = 0.0lr = 0.1eps = 1e-9                        # epsilon để tránh log(0)
# Training loopfor epoch in range(1000):    z = X @ w + b    p = sigmoid(z)                # forward pass
    # Binary Cross-Entropy    loss = -np.mean(y * np.log(p + eps) + (1 - y) * np.log(1 - p + eps))
    # Gradient    grad_w = X.T @ (p - y) / n    grad_b = np.mean(p - y)
    # Update tham số    w -= lr * grad_w    b -= lr * grad_b
    if epoch % 200 == 0:        print(f"Epoch {epoch}: loss={loss:.4f}")
# Chuyển xác suất thành nhãn bằng threshold 0.5pred = (sigmoid(X @ w + b) >= 0.5).astype(int)acc = (pred == y).mean()print(f"\nw={w.round(3)}, b={b:.3f}, accuracy={acc:.3f}")
Hãy để ý diễn biến:
- Ban đầu
w = 0,b = 0— mô hình “chưa biết gì”, loss lớn. - Qua mỗi epoch, Gradient Descent cập nhật
wvàb, và loss giảm dần. - Cấu trúc vòng lặp này — forward pass → tính loss → tính gradient → update — chính là khuôn mẫu của một training loop neural network, chỉ đơn giản hơn nhiều.
scikit-learngiúp ta dùng nhanh, nhưng tự code từ đầu giúp hiểu training thực sự diễn ra thế nào. Khi sau này gặp neural network, bạn sẽ nhận ra nó cũng chỉ là phiên bản chồng nhiều lớp của đúng vòng lặp này.
Dùng AI để code Logistic Regression
Bạn hoàn toàn có thể nhờ ChatGPT hay Claude viết code Logistic Regression. Nhưng giá trị của một AI Engineer nằm ở chỗ biết kiểm tra code AI tạo ra, chứ không phải copy–paste mù quáng. Hãy luôn rà soát:
- AI có chia train/test trước khi preprocess không, hay chuẩn hóa cả dataset rồi mới split?
- Có dùng
Pipelineđể scaler chỉ fit trên train, tránh data leakage không? - Có dùng đúng metric cho classification không (confusion matrix, precision, recall, F1, ROC-AUC) — hay chỉ báo mỗi accuracy?
- Có kiểm tra class imbalance không?
- Có nhìn confusion matrix thay vì chỉ tin vào accuracy không?
- Có dùng
predict_proba()khi cần điều chỉnh threshold không? - Có chuẩn hóa dữ liệu trước khi so sánh độ lớn coefficient không?
- Có phân biệt correlation với causation không (không suy ra nhân quả chỉ từ hệ số)?
- Có đặt
max_iterđủ lớn hoặc kiểm tra cảnh báo không hội tụ (convergence warning) không? - Có xem xét regularization và
class_weightkhi dữ liệu lệch không?
Regularization: Cách hạn chế mô hình khớp quá sát dữ liệu train, thường bằng cách phạt độ lớn của weights.
Class weight: Mức đóng góp của từng lớp vào quá trình học; có thể tăng cho lớp ít mẫu để mô hình chú ý hơn.
Một prompt mẫu buộc AI trình bày rõ ràng và tự chỉ ra lỗi thường gặp:
Hãy viết code Python dùng scikit-learn để train Logistic Regression cho mộtbài toán binary classification. Hãy dùng Pipeline để tránh data leakage,đánh giá bằng confusion matrix, accuracy, precision, recall, F1 và ROC-AUC.Sau đó thử các decision threshold khác nhau và giải thích trade-off giữaprecision và recall. Cuối cùng, hãy chỉ ra các lỗi thường gặp trong code.Mini project
Project 1: Phân loại ung thư vú
Dùng dataset có sẵn trong scikit-learn:
from sklearn.datasets import load_breast_cancerMục tiêu:
- Train Logistic Regression (nhớ dùng pipeline có
StandardScaler). - Đánh giá bằng confusion matrix, precision, recall, F1 và ROC-AUC.
- Thử thay đổi threshold và quan sát precision/recall dịch chuyển.
- So sánh độ lớn coefficient sau khi đã chuẩn hóa để xem feature nào ảnh hưởng mạnh (nhớ: hệ số lớn không tự động nghĩa là “quan trọng nhất” nếu có đa cộng tuyến).
Lưu ý: đây chỉ là bài tập giáo dục, hoàn toàn không phải công cụ chẩn đoán y tế. Xem notebook mẫu để thực hành.
Project 2: Dự đoán khách hàng rời bỏ (churn)
Dùng một dataset churn công khai (ví dụ từ Kaggle).
Mục tiêu:
- Xử lý cả feature số và feature phân loại (categorical).
- Dùng one-hot encoding cho feature phân loại.
- Train Logistic Regression bằng pipeline hoàn chỉnh.
- Chọn threshold theo mục tiêu kinh doanh — ví dụ, nếu giữ chân một khách hàng rẻ hơn nhiều so với mất họ, hãy ưu tiên recall.
- Giải thích ý nghĩa của false positive (tưởng khách sẽ rời nhưng thực ra không) và false negative (bỏ sót khách sắp rời) trong ngữ cảnh churn.
Xem notebook mẫu để thực hành.
Tóm tắt
- Logistic Regression dùng cho classification — dự đoán một mẫu thuộc lớp nào, dù tên có chữ “Regression”.
- Mô hình tính một linear score
z = wᵀx + brồi đưa qua sigmoid để ra xác suất. - Output là xác suất, và một threshold (mặc định 0.5, có thể chỉnh) mới chuyển xác suất thành nhãn.
- Binary Cross-Entropy là loss chuẩn — nó phạt nặng những dự đoán sai nhưng quá tự tin, và được tối ưu bằng Gradient Descent giống Linear Regression.
- Không nên đánh giá chỉ bằng accuracy, nhất là khi dữ liệu mất cân bằng; hãy nhìn confusion matrix, precision, recall, F1 và ROC-AUC.
- Đây là một baseline nhanh, nhẹ, dễ giải thích và vẫn hữu ích trong thực tế — nhưng không phù hợp cho mọi bài toán, đặc biệt khi ranh giới phi tuyến.
Ôn tập
Làm 4 câu trắc nghiệm, 1 câu điền số và 2 câu tự luận ngắn. Trắc nghiệm và câu điền số được kiểm tra tự động; câu tự luận có đáp án gợi ý để bạn tự đối chiếu.